News
Aktuelles aus Virtualisierung, System-Management und lokaler KI.
05.11.2026 · Praxis · Agenten-Architektur
Raspberry Pi + NVIDIA DGX Spark: Der Agent läuft sparsam, die Tokens kommen lokal
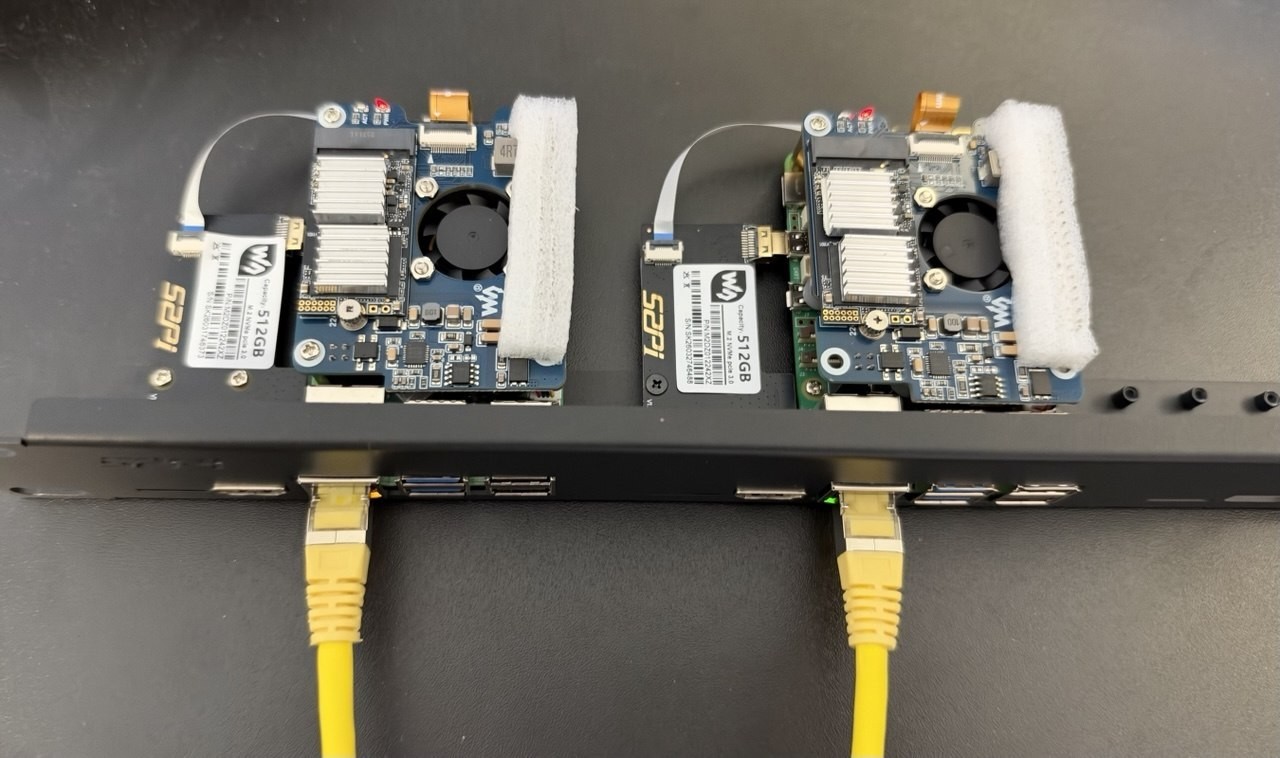
Ein KI-Agent besteht aus zwei Teilen: dem Sprachmodell, das denkt und Text erzeugt, und dem Harness – der Software rundherum, die Aufgaben entgegennimmt, Werkzeuge aufruft, sich Dinge merkt, Zeitpläne abarbeitet und Ergebnisse zurückmeldet. Beide Teile haben völlig unterschiedliche Anforderungen an die Hardware. Genau hier setzt unser Aufbau an: Der Harness läuft auf stromsparenden Raspberry-Pi-Rechnern, das Modell auf einer NVIDIA DGX Spark im eigenen Netz.
Warum diese Aufteilung?
Der Harness braucht kaum Rechenleistung – er wartet die meiste Zeit auf Nachrichten, Termine oder Antworten des Modells. Dafür muss er rund um die Uhr erreichbar sein. Ein Raspberry Pi erledigt das mit einer Leistungsaufnahme im einstelligen Watt-Bereich. Das Sprachmodell dagegen braucht viel Speicher und GPU-Leistung, aber nur dann, wenn tatsächlich gedacht wird. Dafür ist die DGX Spark mit ihrem Unified Memory (64 oder 128 GB) gebaut.
So arbeiten die beiden zusammen
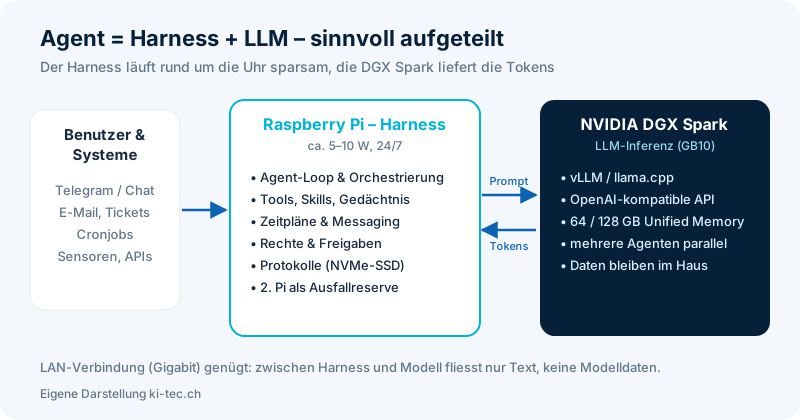
- Raspberry Pi = Harness: Hier laufen der Agent (z. B. Hermes Agent oder OpenClaw), seine Werkzeuge, Skills und sein Gedächtnis, die Anbindung an Telegram, E-Mail oder Ticketsysteme sowie geplante Aufgaben. Die NVMe-SSD speichert Protokolle, Wissensbasis und Verlauf schnell und zuverlässig – deutlich robuster als eine SD-Karte.
- DGX Spark = Token-Fabrik: Ein Inferenz-Server wie vLLM oder llama.cpp stellt das Modell über eine OpenAI-kompatible Schnittstelle im LAN bereit. Der Agent auf dem Pi schickt seinen Prompt dorthin und bekommt die Antwort zurück – genau so, als würde er eine Cloud-API nutzen, nur dass alles im Haus bleibt.
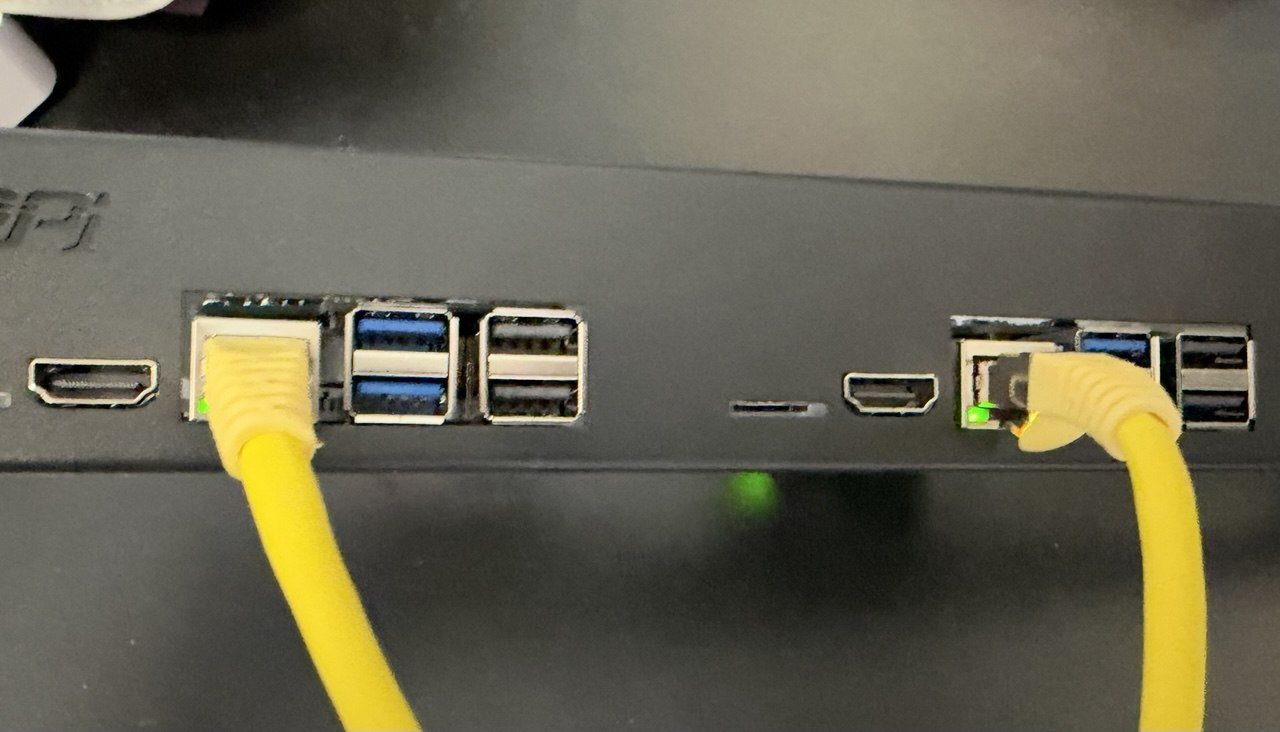
- Gigabit-LAN reicht: Zwischen Harness und Modell fliesst nur Text. Das Modell selbst bleibt auf der Spark; die Netzwerklast ist minimal.
- Mehrere Agenten, ein Modell: Die Spark bedient Anfragen mehrerer Agenten parallel. So können auf den Pi-Knoten verschiedene Agenten für unterschiedliche Aufgaben laufen, die sich ein leistungsfähiges Modell teilen.
Die Vorteile im Alltag
- Stromsparend rund um die Uhr: Der Dauerbetrieb liegt beim Pi, nicht bei der GPU. Die Spark arbeitet nur, wenn Tokens gebraucht werden.
- Ausfallsicherheit: Mit zwei Pi-Knoten kann einer den Agenten betreiben und der andere als Reserve oder für Backups dienen. Fällt ein Knoten aus, übernimmt der zweite.
- Sicherheit durch Trennung: Der Agent mit seinen Zugriffsrechten auf Systeme und Daten läuft getrennt vom Modell-Server. Rechte, Freigaben und Protokolle lassen sich auf dem Harness gezielt steuern, ohne die GPU-Maschine anzufassen.
- Daten bleiben im Haus: Weder Prompts noch Firmendaten verlassen das eigene Netz – ideal für KMU mit sensiblen Informationen und DSGVO-/DSG-Anforderungen.
- Keine Token-Kosten: Ein Agent, der den ganzen Tag arbeitet, verursacht keine laufenden API-Gebühren – nur Strom.
- Flexibel ausbaubar: Wird mehr Modellleistung gebraucht, kommt eine zweite Spark dazu oder eine DGX Station; am Harness ändert sich nichts. Umgekehrt kann bei Bedarf auch ein Cloud-Modell als Ausweichlösung angebunden werden.
Unser Fazit: Die Kombination aus Raspberry Pi als dauerhaft laufendem Harness und NVIDIA DGX Spark als lokalem Modell-Server ist für KMU eine der effizientesten Arten, KI-Agenten produktiv zu betreiben – sparsam, sicher und ohne Abhängigkeit von der Cloud. Wir zeigen Ihnen den Aufbau gerne live und unterstützen bei Planung, Installation und Betrieb.
Fotos und Grafik: ki-tec.ch
05.11.2026 · NVIDIA DGX Spark & DGX Station
Lokale KI für Unternehmen: DGX Spark und DGX Station – das Update November 2026
KI-Agenten sind 2026 im Alltag angekommen – und mit ihnen der Token-Verbrauch. Laut NVIDIA ist das wöchentliche Token-Volumen auf OpenRouter seit Januar 2025 um rund das 300-Fache gestiegen; Agenten verbrauchen inzwischen mehr Tokens als Menschen. Open-Source-Agenten-Frameworks wie OpenClaw oder Hermes gehören auf GitHub zu den populärsten Projekten überhaupt. Wer Agenten produktiv einsetzt, stellt sich deshalb die Frage: Cloud-API oder eigene Hardware? Wir fassen die neuen Informationen von NVIDIA zu den beiden Desktop-Plattformen zusammen.
Warum lokal?
Ein Agent besteht aus dem Sprachmodell und einem „Harness“ – Prompts, Werkzeuge, Orchestrierung, Sicherheitsregeln und Gedächtnis. Läuft beides lokal, ergeben sich vier Vorteile:
- Datenschutz: Firmendaten verlassen das Gerät nicht.
- Verfügbarkeit: keine Abhängigkeit von Internet oder Cloud-Anbieter.
- Tempo: der Agent arbeitet direkt bei Daten und Werkzeugen.
- Planbare Kosten: keine Abrechnung pro Token – NVIDIA nennt als Warnbeispiel einen Agenten in einer Endlosschleife, der in 11 Tagen 47’000 USD Cloud-Kosten verursacht hat.
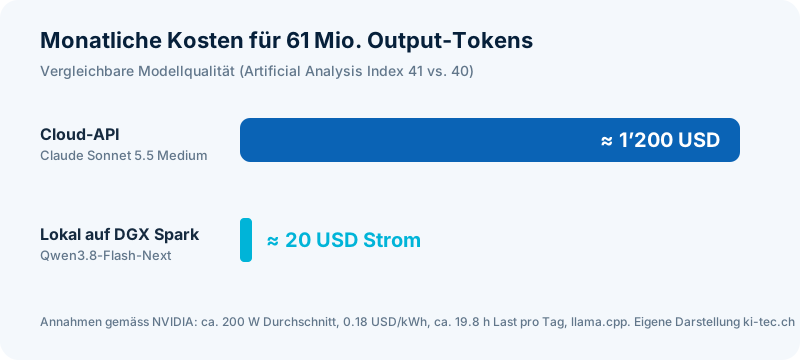
(Grafiken antippen bzw. anklicken zum Vergrössern.) NVIDIA-Rechenbeispiel: Ein Modell mit vergleichbarer Qualität (Qwen3.8-Flash-Next gegenüber Claude Sonnet 5.5 Medium) erzeugt auf der DGX Spark 61 Mio. Output-Tokens pro Monat für rund 20 USD Strom statt rund 1’200 USD API-Gebühren.
Neu: DGX Spark mit 64 GB
Neben der bekannten 128-GB-Version gibt es die DGX Spark (GB10) neu als 64-GB-Variante – den günstigeren Einstieg in die Familie, erhältlich ausschliesslich über ausgewählte OEM-Partner. Sie bringt den kompletten CUDA-Software-Stack und ConnectX-7-Netzwerk zum Clustern mit. Die aktuellen kompakten Open-Source-Modelle, die laut NVIDIA an die Qualität von Frontier-Modellen heranreichen, passen bequem in den Speicher:
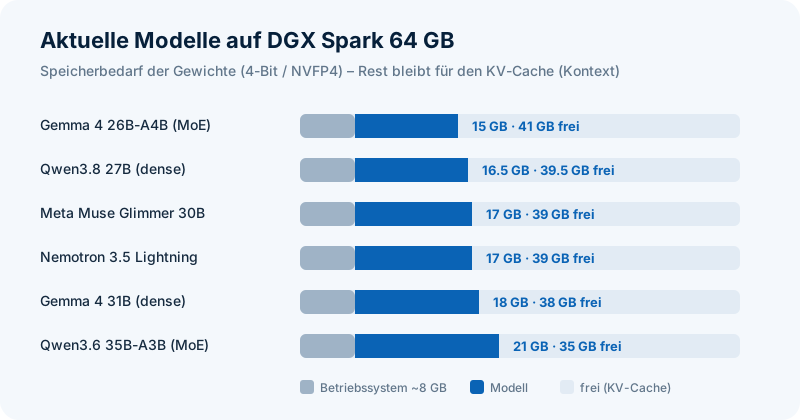
- DGX Spark 64 GB: 64 GB LPDDR5x Unified Memory, Modelle bis ca. 100 Mrd. Parameter (FP4) – die beste Balance aus Speicher, Leistung und Preis.
- DGX Spark 128 GB: 128 GB Unified Memory, Modelle bis ca. 200 Mrd. Parameter – über OEM-Partner und als NVIDIA Founders Edition.
Mehrere Sparks im Verbund
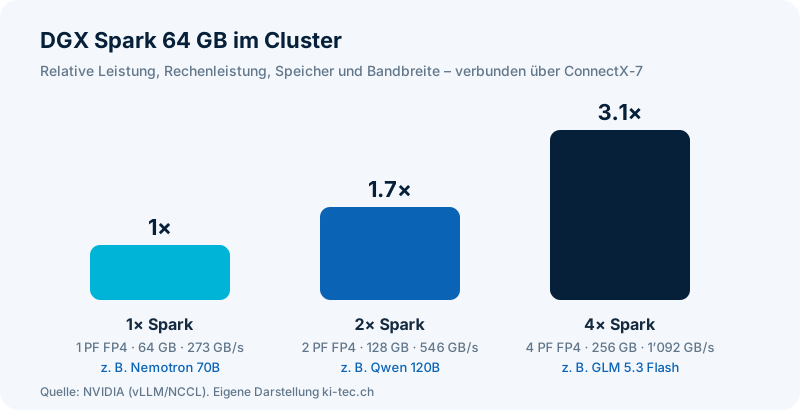
Bis zu vier Systeme lassen sich koppeln; die Modellschichten werden über NCCL und ConnectX-7 verteilt (optimal mit 2 oder 4 Geräten). Im NVIDIA-Benchmark läuft Qwen3.8-27B auf zwei 64-GB-Sparks 1,7-mal schneller als auf einem einzelnen Gerät.
- NVIDIA Sync: verbindet Windows-, macOS- oder Ubuntu-Laptops mit der Spark – auch unterwegs per Tailscale; VS Code oder Cursor starten per Klick. Ein Cluster-Assistent erkennt bis zu vier Sparks und richtet Netzwerk und SSH automatisch ein.
- Fertige Playbooks (build.nvidia.com/spark): vLLM über mehrere Sparks, Nemotron-3-Modelle, NemoClaw-Assistent in einer Sandbox, Hermes Agent mit lokalen Modellen sowie OpenClaw mit lokalem vLLM-Modell.
- Bereit für den Firmeneinsatz: Hardware Root of Trust, Secure Boot, NVMe-Vollverschlüsselung, BIOS-Sperre und Port-Kontrolle, Air-Gap-Betrieb, DSGVO-konforme Telemetrie (standardmässig aus), Integration in Landscape, Ansible, Puppet, FleetDM, PXE und MDM sowie OTA-Updates.
- Software-Bausteine für Agenten: NVIDIA OpenShell (abgesicherte Laufzeitumgebung mit Richtlinien für Datei- und Netzzugriff, die der Agent selbst nicht verändern kann), NemoClaw-Vorlagen für Dauerläufer-Agenten, Nemotron-Modelle, Open Agent Safety Platform und NVIDIA AI Enterprise (90 Tage kostenlos testbar).
DGX Station: die Token-Fabrik unter dem Schreibtisch
Für Teams und Abteilungen positioniert NVIDIA die DGX Station mit GB300 Grace Blackwell Ultra. Sie führt auch Modelle mit einer Billion Parametern lokal aus und bedient hunderte Agenten gleichzeitig – laut NVIDIA bis zu achtmal mehr Durchsatz als eine RTX-PRO-Workstation.
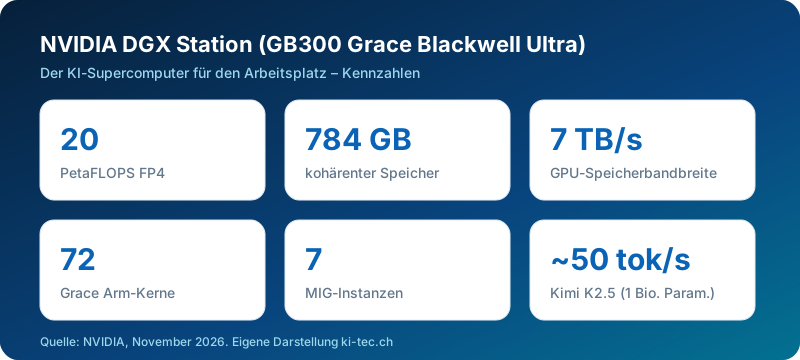
- Leistung: Kimi K2.5 (1 Bio. Parameter) mit rund 50 Tokens/s; im Benchmark 256 parallele Agenten mit Qwen3.6-35B.
- Grafik dazu: zusätzlich zum GB300 eine RTX PRO Blackwell-Karte (6000, 6000 Max-Q, 4000 SFF oder 2000) für Visualisierung, Simulation und Physical AI.
- Verwaltung & Sicherheit: BMC mit Redfish-API, vorkonfiguriertes DCGM, bis zu 7 MIG-Instanzen für mehrere Benutzer, TPM als Hardware Root of Trust, Enterprise Secure Boot mit signierter Firmware, Air-Gap-fähig.
- Software: vorinstalliertes Ubuntu mit NVIDIA AI Developer Tools, Playbooks unter build.nvidia.com/station; NVIDIA AI Enterprise mit 9 Monaten Support für den Produktionszweig.
- Clustering: zwei Stationen über ConnectX-8 – bis 40 PFLOPS FP4, knapp 1,5 TB Speicher und 14 TB/s Bandbreite.
- Neu für Windows: ab Q4 kommt die DGX Station auch mit Windows und Windows-Enterprise-Verwaltung (GB300, 20 PFLOPS, bis 748 GB, ConnectX-8 bis 800 Gb/s).
Wo wird das eingesetzt?
NVIDIA nennt Anwender aus Forschung, Gesundheitswesen, Energie, Industrie, Finanzwesen, Medien und öffentlicher Hand. Beispiele: Hochschulen trainieren lokal Sprachmodelle mit mehreren Milliarden Parametern, Medizin-Startups segmentieren CT-Bilder in Sekunden, Energieversorger rechnen hochauflösende Wetterprognosen für das Stromnetz, und Ingenieurteams führen Fine-Tuning von Modellen mit über 70 Mrd. Parametern ohne Quantisierung durch – alles am Arbeitsplatz statt im Rechenzentrum.
Unser Fazit: Für die meisten KMU ist die DGX Spark 64 GB jetzt der attraktivste Einstieg in lokale KI-Agenten; wer viele Benutzer oder sehr grosse Modelle bedienen will, landet bei der DGX Station. Für Bildung, Forschung und Startups gibt es Programme mit attraktiven Konditionen – sprechen Sie uns an, wir beraten Sie gerne bei Auswahl, Installation und Betrieb.
Quelle: NVIDIA, Partner-Präsentation November 2026. Alle Grafiken: eigene Darstellung ki-tec.ch auf Basis der NVIDIA-Angaben. · build.nvidia.com/spark · build.nvidia.com/station
27.10.2026 · HP ZGX Fury AI Station
HP ZGX Fury: GB300-Kraft für das ganze Team – offizieller Launch
HP hat die ZGX Fury AI Station (G1n) offiziell vorgestellt – die HP-Ausführung der NVIDIA-GB300-Klasse. Ein Tower für gemeinsam genutzte lokale KI: Entwicklung, Fine-Tuning und Produktions-Inferenz auf einem Gerät, ohne Token-Gebühren und ohne Cloud-Abhängigkeit.
- NVIDIA GB300 Grace Blackwell Ultra Superchip: bis zu 20 PFLOPS FP4 und 748 GB kohärenter Unified Memory – lokale Modelle bis ca. 1 Billion Parameter (FP4), Fine-Tuning bis ca. 100-Mrd.-Klasse.
- Software vorbereitet: Ubuntu 24.04 LTS vorinstalliert inkl. NVIDIA AI Developer Tools (Treiber, CUDA, Container); Windows-Support angekündigt (Q4 2026); für Red Hat AI Enterprise zertifiziert.
- HP Z Toolkit & Z Runtime: VS-Code-Erweiterung für Setup, Remote-Management und Modell-Tracking; mit einem Befehl Modelle pullen und als Inferenz-Endpunkt betreiben.
- Sicherheit & Storage: 2 oder 4 TB NVMe M.2 mit Selbstverschlüsselung; sensiblen Daten bleiben on-premises – für regulierte Branchen, Behörden, Healthcare und Forschung konzipiert.
- Rack-fähig: Flüssigkühlung, Front-to-Back-Airflow, 2x QSFP112 (400 Gb/s) für Clustering, 10 GbE + BMC-LAN; optionale NVIDIA RTX PRO-GPU als Display-Ausgabe.
Video: HP Z Workstations & Solutions (offizieller Launch-Clip) · Alle Daten: hp.com
27.10.2026 · Video · NVIDIA DGX Stations
Video: NVIDIAs neue DGX Stations im Überblick
Guter Überblick über die neue DGX-Station-Klasse (GB300) und ihre Wirkung auf den KI-Markt – das passt zu unserem News-Beitrag unten. Das Video stammt vom YouTube-Kanal Evolving AI:
27.10.2026 · NVIDIA Grace Blackwell
NVIDIA AI Workstations: GB10 & GB300 im Überblick
NVIDIA hat zwei Klassen von KI-Workstations am Markt: der GB10 Grace Blackwell als Personal AI Desktop für einzelne Entwickler und kleine Teams – und der GB300 Grace Blackwell Ultra als Deskside AI Station mit Rechenzentrums-Silizium für den abteilungsweiten Betrieb. Alle Modelle sind verfügbar; die wichtigsten Fakten:
- GB10 – Personal AI Desktop: 1 PFLOP FP4, 128 GB Unified Memory, 273 GB/s, 240 W – Inferenz bis ca. 200B Parameter (FP4), mit zwei gekoppelten Systemen bis ca. 405B. 8 Modelle am Markt, Listenpreis ab ca. 3.100 USD – aktueller Marktpreis inzwischen ca. 5.500 CHF.
- GB300 – Deskside AI Station: 20 PFLOPS FP4, 748 GB kohärenter Speicher, 7,1 TB/s, 1.600 W – Modelle bis ca. 1 Billion Parameter, MIG-Partitionierung in bis zu 7 isolierte Instanzen. 7 Modelle am Markt, ca. 85.000–126.000 USD.
- Hersteller: NVIDIA, ASUS, Dell, GIGABYTE, HP, Lenovo, MSI, Supermicro, Acer – identisches Silizium pro Klasse, Unterschiede bei Storage, I/O, Support und Compliance (z. B. TAA-Variante von ASUS).
- Wichtig für Planung: Identischer CUDA-Stack in beiden Klassen – Workloads wandern ohne Portierung zwischen GB10-Arbeitsplatz und GB300-Station. Arm64-Kompatibilität der Toolchain vorab prüfen; 1.600 W Anschlussleistung beim GB300 einplanen.
GB10 – für den Arbeitsplatz
Prototyping, Fine-Tuning bis 70B, lokale Inferenz – Betrieb an haushaltsüblicher Steckdose. Ideal für Entwickler.
GB300 – für die Abteilung
Souveräne KI, Frontier-Open-Weights im Eigenbetrieb, bis 7 Nutzergruppen – der Token-Durchsatz liegt Faktor 26 über GB10.
Mehr zu lokalen KI-Systemen und deren Betrieb: Lokale KI-Systeme →